

做到 Day 26,我其實已經有一條看起來很完整的 Demo:
原始教材
→ 找到概念
→ 開啟互動表示
→ 直接操作
→ 多個畫面同步
→ 回到原始教材
如果只是要做一支漂亮的展示影片,其實做到這裡已經很夠了。
但我開始有點不放心。
因為前面很多成功案例,都是在開發過程中反覆看過、修過、測過的材料。即使我沒有刻意為它們寫 hardcode,整套系統仍然有可能在不知不覺中「長成很適合這些案例的樣子」。
所以 Day 27 我決定不再加新功能。
反而做一件更危險的事:
拿一批 Visual Learning Lab 從來沒看過的真實教材,直接攻擊現在的產品。
而且這次失敗不能刪。
Day 27 開始前,我先把 production model 統一升到:
gpt-6.1-sol
reasoning: medium
我原本有考慮做新舊模型 A/B,但最後放棄了。
原因很簡單:剩下的比賽時間已經不多,我更想把時間花在「作品本身到底能不能泛化」上,而不是證明哪一個模型多幾個百分點。
所以今天沒有模型 PK。
模型直接換掉,然後把省下來的工作量全部拿來做更大的真實教材測試。
這次我挑了 10 組不同型態的真實教材:
| 案例 | 類型 |
|---|---|
| 圓周運動 | 空間/物理 |
| 簡諧運動 | 振動/物理 |
| RC 電路 | 電路/動態系統 |
| 聲音與訊號 | 波形/頻譜 |
| 最小平方迴歸 | 統計/數值關係 |
| 有限機率事件 | 集合/機率 |
| 搜尋演算法 | 流程/演算法 |
| Big-O | 漸近比較 |
| NASA 電磁頻譜表 | 表格/尺度換算 |
| Debugging | 純概念/流程 |
我刻意沒有選 10 個類似拋體運動的案例。
因為如果系統只會把物理公式做成 slider,再漂亮也不能叫做 Universal Learning World。
更重要的是,在任何付費模型請求開始之前,我先把每一案的人工預期全部寫完並凍結,包括:
而且這份標準不是模型跑完之後才補的。
Day27 benchmark 開始時:
Paid API requests = 0
期待值、deep subset、stability subset、檔案 hash 全部先凍結。
這樣至少可以避免最危險的一件事:
看到模型做出了什麼,再偷偷修改「成功」的定義。
這次還有一個和以前很不一樣的地方。
我沒有只問:
Compiler 有沒有成功?
而是把結果拆成兩條完全不同的軸。
A. Semantic / Source Correctness
教材理解到底對不對?

B. Engineering / Runtime
系統到底跑不跑得動?
B 軸可以自動化檢查:
但 A 軸不能讓 AI 自己當裁判。
因為 Validator 通過,只代表:
「這份宣告在系統規則裡合法。」
完全不代表:
「它真的理解教材。」
10 份教材第一次跑完後,B 軸結果其實很好看:
Engineering / Runtime

PASS 8 / 10
FAIL 2 / 10
20 個 first-pass responses 全部通過 Structured Output schema。
如果今天我要寫一篇漂亮宣傳文,我大概可以停在這裡:
「陌生教材成功率 80%!」
但真正做人工作業後,事情完全不一樣。
這是最讓我警覺的一案。
教材中有一組真實樣本統計量:
R = -0.499
它不是一個讓學生自由玩的參數。
它是這一批實際資料算出來的 correlation。
但第一版 Visual Learning Lab 做了什麼?
直接把:
corr = -0.499
做成 slider。
學生可以把它拉到其他值,然後 slope、intercept 跟著一起改。
從數學角度看完全沒問題。
公式仍然成立:
b₁ = (sᵧ / sₓ)R
但從教材角度看,這已經是另一回事。
因為畫面正在暗示:
這個來源資料的 correlation 是可以隨便改的。
這就是我今天第一次非常明確地看到:
數學正確,不代表教材理解正確。
機率教材裡原本定義:
A = {1, 2}
B = {4, 6}

P(A) = 1/3
P(B) = 1/3
這些是教材裡已定義好的事件。
結果系統又把 P(A)、P(B) 變成可調參數。
一樣,公式沒壞。
Union:
P(A ∪ B)
=
P(A) + P(B) - P(A ∩ B)
還是算得出來。
但是那個 slider 已經不再代表教材裡的 A 和 B。
我們把「來源事實」和「為了探索而創造的假想參數」混在一起了。
最後我沒有替自己的產品護航。
第一次人工 A 軸結果:
| 結果 | 數量 |
|---|---|
| PASS | 4 |
| PARTIAL | 4 |
| FAIL | 2 |
也就是:
Engineering
8 PASS / 2 FAIL

Semantic correctness
4 PASS / 4 PARTIAL / 2 FAIL
這是我覺得 Day27 最重要的一個數字。
因為它證明:
「程式有跑」真的不能當成「學習工具正確」。
除了 10 案 breadth test,我還事先選了五案做更深的 Golden Path:
測的是:
Source
→ semantic entity
→ representation
→ interaction/state
→ Source
表面上其實都可以操作。
Slider 可以動。
Canonical state 會更新。
Graph 會變。
回 Source 也還找得到原來的 focus。
而且:
post-compilation API delta = 0
但深入檢查後發現一個問題:
五案選中的 Source entity:
representation_ids = []
全部都是空的。
也就是我畫面上明明「有東西可以看」,但系統並沒有正式證明:
這一個 source semantic entity,真的就是由這一個 representation 表達。
這對 Grounded Semantic Twin 是一個很大的漏洞。
最簡單的修法其實很誘惑人。
看到:
representation_ids = []
直接找到附近一張圖,把 ID 塋進去。
Demo 馬上漂亮。
但那就違反我前面一直守的原則。
因為:
看起來有關
≠
真的表示同一個 semantic entity
所以我先停下來做 root-cause audit。
最後抓出了兩個跨案例問題。
以前的 numeric parameter 大致只有:
fixed
adjustable
而 fixed / adjustable 又主要是看:
min == max ?
問題是這完全不夠。
所以 Day27 加進了一個新的 provenance contract:
source_fixed
source_variable
hypothetical_exploration
derived
其中最重要的是:
source_fixed
這個東西只要是來源事實,就不能被 learner interaction 改掉。
如果我要拿它做 what-if:
不能直接改原本那個 ID。
而是必須建立另一個:
reported_correlation
    provenance = source_fixed
    value = -0.499

explore_correlation
    provenance = hypothetical_exploration
    source_baseline_ref = reported_correlation
它們可以長得很像。
但語意上不是同一個東西。
這個改動也讓系統第一次正式區分:
SOURCE
教材真正說了什麼

COMPILED / INITIAL EXPLORATION
AI 建立的實驗初始值

CURRENT EXPLORATION
使用者現在玩到哪裡
以前畫面上雖然已經有 baseline/current,但 baseline 很多時候其實只是「模型 default」。
不能保證就是 source truth。
現在這層身分開始被正式保存。
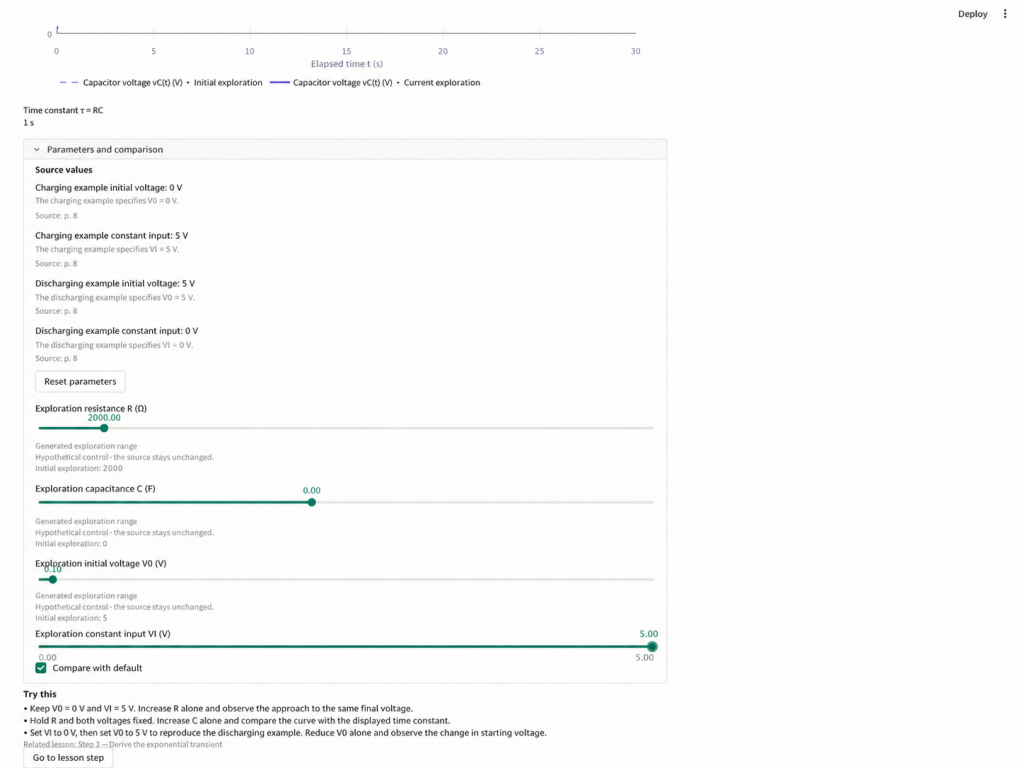
教材裡有兩個例子:
Charging:
(V0, VI) = (0, 5)

Discharging:
(V0, VI) = (5, 0)
Post-fix 之後,它們被保留成四個不可改的 source facts。
另外的探索才是:
hypothetical R
hypothetical C
hypothetical V0
hypothetical VI
我實際把探索的 V0:
0 → 0.1 V
來源裡的:
0 / 5
5 / 0
完全沒有變。
這件事情看起來很小。
但我覺得它其實是 Visual Learning Lab 從「有互動的 AI App」變成「比較可信的學習工具」很重要的一步。
另一個修正是:
semantic entity
↔ representation
以前 Numeric Lab 會試著猜:
整個 Lab 最主要是在講哪一個 semantic entity?
然後把整包 series / metrics 掛到那裡。
這在簡單 demo 裡可能沒問題。
但真實教材不是這麼乾淨。
一個 Lab 裡可能同時有:
它們不一定全部代表同一件事。
所以現在 representation ownership 必須明確宣告。
而且是可以 many-to-many,但每一條關係都要驗證:
semantic ID exists
material matches
representation exists
page provenance compatible
不能靠:
來建立 ownership。
這裡也刻意保留一個重要區別:
semantic entity
↔ representation
和:
semantic entity
↔ manipulation target
不是同一件事。
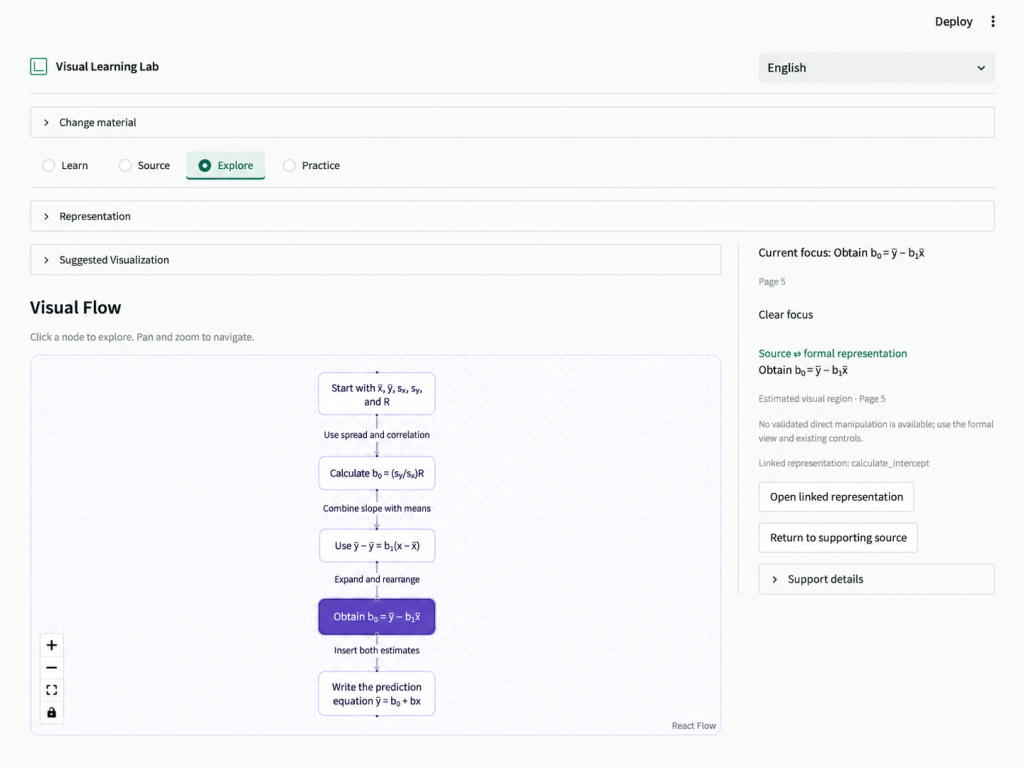
所以 post-fix 之後,五個 deep entities 原本的:
representation_ids = []
現在都能連到真實存在的 formal representation。
但:
manipulation_target_ids = []
五案仍然全部是空的。
這不是失敗。
反而是我想看到的結果。
因為系統現在可以說:
我知道哪個畫面在表達這個概念。
但不會因此假裝:
所以這個東西一定可以被拖。
Probability 是今天最好的例子。
第一版是 FAIL。
Post-fix 後:
都變成 immutable source facts。
Hypothetical probability exploration 使用另外的 semantic IDs。
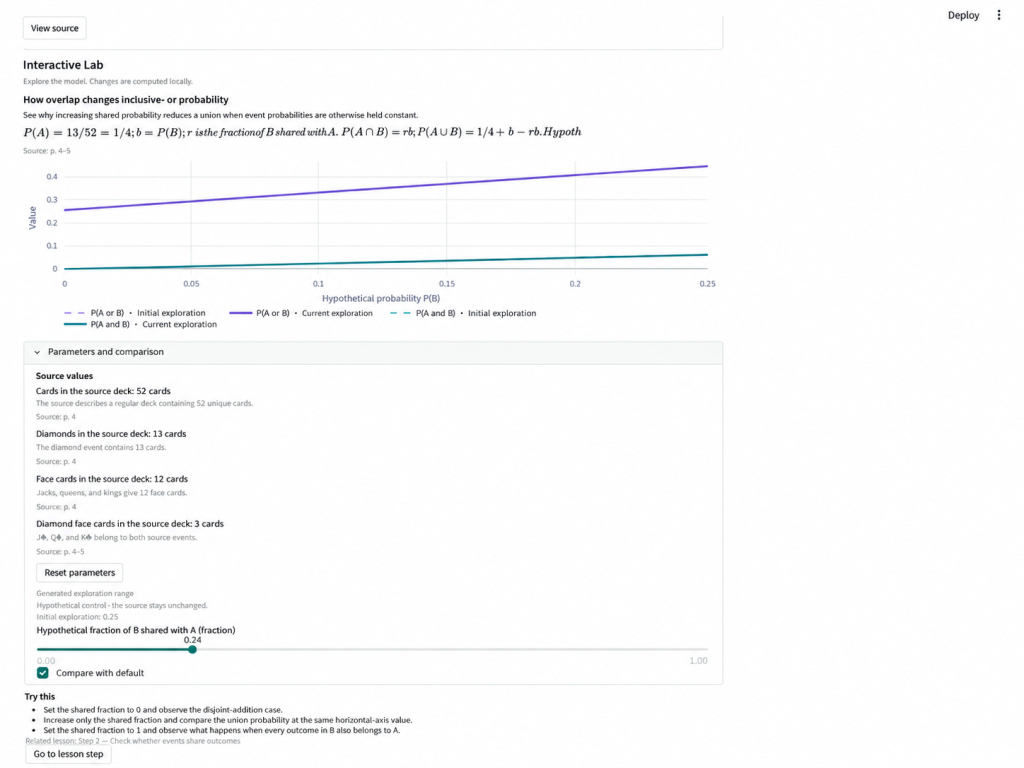
所以原本「來源機率被直接當 slider」的問題被修掉了。
但我沒有因此把它判成 PASS。
因為真正的:
Probability Sets runtime
這次還是被 structural compiler 拒絕。
有限事件 membership 的完整互動世界還沒有成功建立。
所以最後我只給:
PARTIAL
這也是我今天想保留的一個態度:
修掉一個嚴重 bug,不代表整個案例突然完美。
A+B 修完後,我重新做人工作業。
結果:
Baseline A-axis

PASS       4
PARTIAL    4
FAIL       2
變成:
Post-fix A-axis

PASS       5
PARTIAL    5
FAIL       0
不是:
10 PASS
Probability 還是 PARTIAL。
RC 也還是 PARTIAL。
Signals 甚至從原本可以互動的 Numeric Lab,退化成 static/formal fallback。
但 Signals 的教材語意仍然是正確的,所以 A 軸維持 PASS。
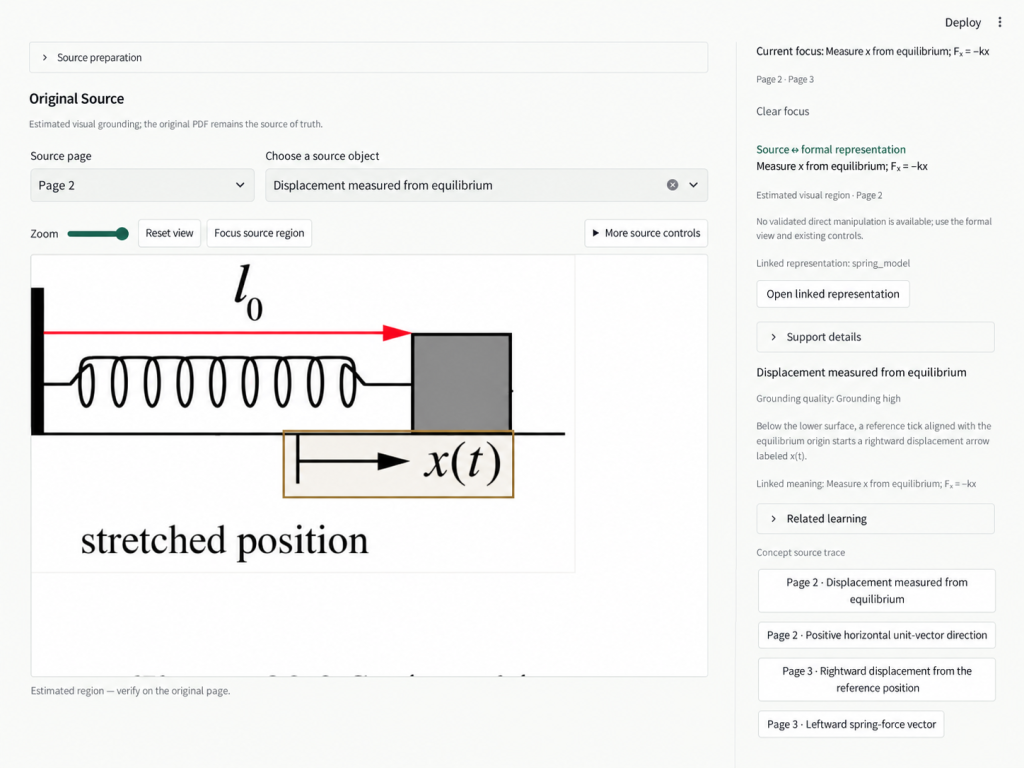
這也是今天另一個很重要的結論:
產品能力退化,和教材語意錯誤,是兩種完全不同的 failure。
Day27 audit 還抓到第三個問題:
目前 representation planner 對 Numeric Lab 有明顯 availability bias。
原因之一是:
Numeric Lab = ready
Spatial / Structural = candidate
而 planner 又沒有看到完整的 artifact capability manifest。
所以很多案例會傾向選「已經可以直接用」的 Numeric Lab。
Probability 和 Search 尤其明顯。
但今天我沒有修。
因為 Day27 一開始就規定:
最多只修兩個 systemic problems。
最後我選:
A. Source fact vs hypothetical exploration
B. Semantic-to-representation ownership
Candidate C 留成 limitation。
不因為今天還有時間,就繼續把 benchmark 修到漂亮為止。
這次 Day27 的付費實驗其實不少。
Baseline benchmark:
37 requests
input  291,191 tokens
output 83,853 tokens
Post-fix bounded replay:
16 requests
input  187,073 tokens
output 60,210 tokens
合計:
53 requests

input  = 478,264 tokens
output = 144,063 tokens

total = 622,327 tokens
全部:
gpt-6.1-sol
reasoning = medium
semantic retries = 0
累積記錄到的 model response latency 約:
2,072.639 seconds
≈ 34.5 minutes
這個數字是所有 request latency 的累加,不是完整使用者等待時間 benchmark。
而所有已經編譯完成後的普通 interaction:
API delta = 0
A、B 修完之後,第一次完整 regression 並沒有直接全綠。
結果:
480 / 489 passed

6 failures
3 errors
主要是舊 fixture / cache compatibility 被新的 contract 影響。
修正之後先跑 focused:
105 / 105 passed
最後再跑一次完整 regression:
489 / 489 passed
0 failures
0 errors
0 skips

242.890 s
到這裡我才把 Day27 關掉。
今天沒有證明:
Visual Learning Lab 已經適用所有教材。
也沒有證明:
GPT-6.1 Sol 可以永遠正確理解教材。
更沒有證明:
10 個案例已經具有統計代表性。
今天真正證明的是:
我第一次把作品丟進一個事先凍結的陌生教材測試裡。
然後它真的失敗了。
而且其中有些失敗不是畫面醜、不是 compiler exception。
是更危險的:
系統把來源事實,變成了學生可以隨便改的參數。
如果今天只看 automated tests,我很可能不會發現。
最後我留下:
Engineering first-pass:
8 PASS / 2 FAIL

Human semantic baseline:
4 PASS / 4 PARTIAL / 2 FAIL

After two systemic fixes:
5 PASS / 5 PARTIAL / 0 FAIL

Final regression:
489 / 489
原始失敗、baseline、hash、request usage 全部保留。
Post-fix evidence 另外存放。
沒有拿新的結果回頭覆蓋第一次 benchmark。
Day 27 做完之後,我反而更確定剩下三天不該再一直加功能。
Visual Learning Lab 現在真正需要證明的是:
它準不準?
人找不找得到?
真的有沒有幫助理解?
公開給別人用會不會炸?
所以 Day 28 不再測 compiler。
我要把它交給真正的人。
而且這次不是我站在旁邊教他:
「先按這裡,再選那個,再開 Twin。」
而是讓第一次看到 Visual Learning Lab 的人,從首頁自己開始。
我也想加一個很小、很克制的比較:
只看原始 PDF,和使用 Visual Learning Lab,理解同一類概念時到底有沒有差?
3~5 個人當然不能證明「提升學習成效」。
但至少我們終於可以開始回答:
除了工程師覺得很酷之外,學生真的會想用嗎?
Day 28,換人類來攻擊它。


 iThome鐵人賽
 看影片追技術